Contexte : garder la supervision disponible si un serveur Zabbix tombe en panne · Testé sur : 2 nœuds Debian 12, Zabbix 7.0, MariaDB Galera 4, Pacemaker et Corosync pilotés par pcs · Dernière vérification : contenu de 2025 non revérifié
¶ Objectif
Mettre en place, étape par étape, un cluster haute disponibilité (HA) pour Zabbix sur deux nœuds Debian 12 déjà configurés :
- le serveur Zabbix tourne comme ressource unique active, gérée par Pacemaker ;
- la base MariaDB est répliquée en actif-actif par Galera ;
- l'ensemble s'administre avec
pcs,corosync,pacemaker,galeraetrsync.
Zabbix n'accepte qu'un seul processus serveur actif à la fois : c'est Pacemaker qui décide quel nœud le fait tourner.
¶ Prérequis
- Deux nœuds identiques exécutant Zabbix 7.0, MariaDB, PHP 8.2 et Nginx : voir Installer un serveur Zabbix 7 sur Debian 12, puis Créer une VM jumelle Zabbix.
- La résolution de noms entre les nœuds (fichier
/etc/hosts, voir l'étape 2). - Des flux ouverts entre les nœuds :
2224/tcp(pcsd),5405/udp(Corosync),3306/tcp,4444/tcp,4567/tcpet4568/tcp(MariaDB Galera). - Un mot de passe robuste pour le compte de cluster
hacluster, noté<MOT_DE_PASSE_HACLUSTER>dans cette page.
Valeurs d'exemple utilisées dans cette page :
| Nœud | Adresse IP |
|---|---|
SRV-ZABBIX-01 |
192.168.30.10 |
SRV-ZABBIX-02 |
192.168.30.20 |
¶ Étapes
¶ 1. Installer les composants (sur les deux nœuds)
sudo apt install -y pacemaker corosync pcs galera-4 rsync
L'installation de Pacemaker crée le compte système hacluster. Définissez son mot de passe, identique sur les deux nœuds (<MOT_DE_PASSE_HACLUSTER>) :
sudo passwd hacluster
Activez les services, puis vérifiez que pcsd écoute sur le port 2224 :
sudo systemctl enable pcsd pacemaker corosync --now
ss -lnpt | grep 2224
¶ 2. Authentifier les nœuds (sur SRV-ZABBIX-01)
sudo pcs host auth SRV-ZABBIX-01 SRV-ZABBIX-02 -u hacluster
pcs demande alors le mot de passe <MOT_DE_PASSE_HACLUSTER>. On peut aussi le passer avec l'option -p, mais il resterait alors dans l'historique du shell.
Si vous obtenez l'erreur suivante :
Error: Hosts 'SRV-ZABBIX-01' not known to pcs
complétez le fichier /etc/hosts sur les deux nœuds, puis relancez l'authentification :
192.168.30.10   SRV-ZABBIX-01
192.168.30.20   SRV-ZABBIX-02
Si l'erreur persiste, voir la section « Dépannage ».
¶ 3. Créer et démarrer le cluster (sur SRV-ZABBIX-01)
sudo pcs cluster setup zabbix-ha SRV-ZABBIX-01 SRV-ZABBIX-02
sudo pcs cluster start --all
sudo pcs cluster enable --all
sudo pcs status
¶ 4. Confier le serveur Zabbix à Pacemaker
Le service zabbix-server ne doit plus être lancé par systemd au démarrage : c'est Pacemaker qui le démarre sur un seul nœud. Sur les deux nœuds :
sudo systemctl disable --now zabbix-server
Sur SRV-ZABBIX-01, désactivez STONITH (acceptable seulement en l'absence de dispositif de fencing, par exemple en maquette), créez la ressource, puis limitez les bascules inutiles :
sudo pcs property set stonith-enabled=false
sudo pcs resource create zabbix-server systemd:zabbix-server op monitor interval=30s
sudo pcs resource meta zabbix-server resource-stickiness=100
¶ 5. Activer le mode HA côté Zabbix
Dans /etc/zabbix/zabbix_server.conf, donnez à chaque nœud son propre nom HA.
Sur SRV-ZABBIX-01 :
HANodeName=SRV-ZABBIX-01
Sur SRV-ZABBIX-02 :
HANodeName=SRV-ZABBIX-02
N'ajoutez pas de commentaire en fin de ligne : Zabbix ne reconnaît les commentaires qu'en début de ligne, et un
# …placé après la valeur ferait partie du nom.
Redémarrez Zabbix uniquement via Pacemaker, jamais à la main, puis vérifiez l'état des ressources :
sudo pcs resource restart zabbix-server
sudo pcs status resources
¶ 6. Mettre en place MariaDB Galera
¶ Premier nœud (SRV-ZABBIX-01)
Arrêtez MariaDB sur les deux nœuds avant de modifier la configuration :
sudo systemctl stop mariadb
Sur SRV-ZABBIX-01, modifiez /etc/mysql/mariadb.conf.d/60-galera.cnf :
[galera]
wsrep_on=ON
wsrep_provider=/usr/lib/galera/libgalera_smm.so
wsrep_cluster_name="zabbix-galera"
wsrep_cluster_address="gcomm://192.168.30.10,192.168.30.20"
bind-address=0.0.0.0
default_storage_engine=InnoDB
binlog_format=row
innodb_autoinc_lock_mode=2
wsrep_node_name="SRV-ZABBIX-01"
wsrep_node_address="192.168.30.10"
Correction : la version d'origine de cette page utilisait
galera_cluster_nameetgalera_cluster_address, que MariaDB ne reconnaît pas. Les noms corrects sontwsrep_cluster_nameetwsrep_cluster_address. La lignewsrep_providerdésigne la bibliothèque Galera installée par le paquetgalera-4.
bind-address=0.0.0.0ouvre MariaDB sur toutes les interfaces : limitez l'accès aux ports de la base aux seuls nœuds du cluster (pare-feu).
Initialisez le cluster Galera à partir de ce premier nœud :
sudo galera_new_cluster
¶ Second nœud (SRV-ZABBIX-02)
Reprenez le même fichier 60-galera.cnf, en ajustant uniquement ces deux lignes :
wsrep_node_name="SRV-ZABBIX-02"
wsrep_node_address="192.168.30.20"
Démarrez MariaDB normalement. Le nœud rejoint le cluster et se synchronise depuis SRV-ZABBIX-01 (transfert complet par rsync) :
sudo systemctl start mariadb
¶ Vérifier la réplication
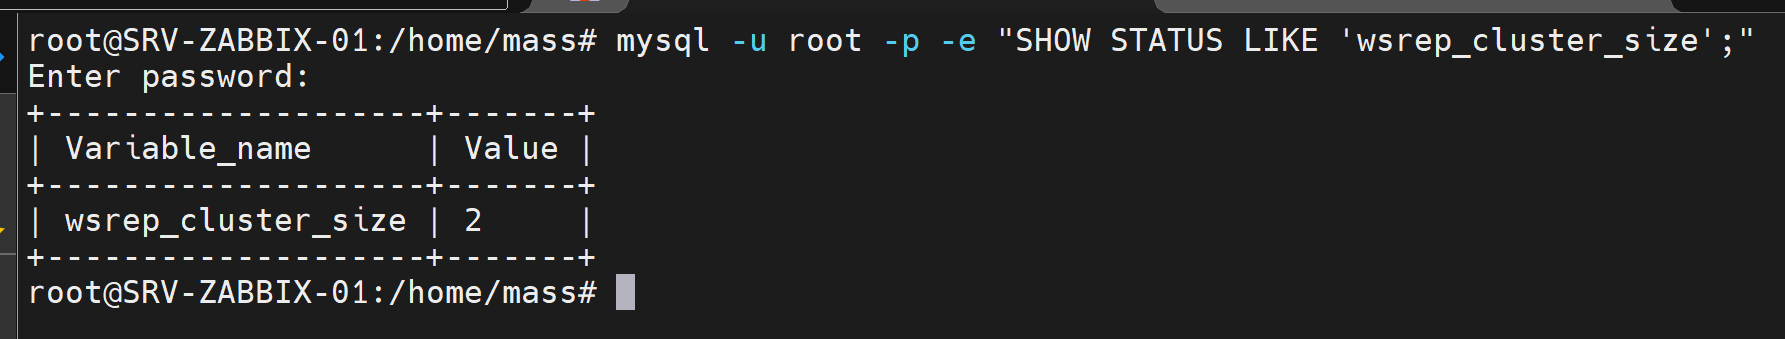
sudo mysql -u root -p
SHOW STATUS LIKE 'wsrep_cluster_size';
La valeur doit être 2.
¶ 7. Tester la bascule
- Vérifiez avec
sudo pcs statussur quel nœud tourne la ressourcezabbix-server, puis ouvrez l'interface sur ce nœud (par exemplehttp://192.168.30.10/). - Éteignez
SRV-ZABBIX-01. - Sur
SRV-ZABBIX-02, vérifiez avecsudo pcs statusque Pacemaker a basculézabbix-server, puis ouvrez l'interface surhttp://192.168.30.20/. - Rallumez
SRV-ZABBIX-01: grâce àresource-stickiness=100, la ressource reste surSRV-ZABBIX-02au lieu de rebasculer aussitôt, et MariaDB rejoint le cluster Galera.
¶ Vérification
- Zabbix ne tourne que sur un seul nœud à la fois (
sudo pcs status). - La base MariaDB est répliquée activement sur les deux nœuds (
wsrep_cluster_size= 2). - Le cluster s'administre à tout moment avec
pcs.
Le cluster Zabbix HA est prêt à encaisser la panne d'un nœud.
Commandes utiles :
# État général du cluster
sudo pcs status

# Redémarrer la ressource Zabbix
sudo pcs resource restart zabbix-server

# Journaux de Corosync
journalctl -xe -u corosync

# Journaux de Pacemaker
journalctl -xe -u pacemaker
Astuce : créez un alias pour surveiller le cluster rapidement.
echo "alias cluster='pcs status'" >> ~/.bashrc && source ~/.bashrc
¶ Dépannage
¶ Erreur « Hosts not known to pcs » malgré /etc/hosts
L'erreur Error: Hosts 'SRV-ZABBIX-01' not known to pcs est apparue même après la correction de /etc/hosts. Elle venait d'un mauvais état du cluster ou d'une mauvaise configuration DNS ou du nom d'hôte.
Solution appliquée :
-
Supprimer le cluster défaillant :
sudo pcs cluster destroy --all -
Refaire l'authentification (étape 2), puis la création du cluster (étape 3).
Si l'état reste incohérent, n'hésitez pas à recloner la VM à partir du premier nœud.
¶ Le second nœud MariaDB ne rejoint pas le cluster
Consultez journalctl -u mariadb sur les deux nœuds. Vérifiez que les ports Galera (4444, 4567, 4568) sont ouverts entre les nœuds et que wsrep_cluster_address liste bien les deux adresses.
¶ Limites de cette maquette
- STONITH désactivé : acceptable en maquette. En production, configurez un dispositif de fencing.
- Pas d'adresse IP virtuelle : après une bascule, il faut changer d'adresse pour joindre l'interface. Une ressource d'adresse IP flottante gérée par Pacemaker lèverait cette contrainte.
- Galera sur deux nœuds : si le lien entre les nœuds est coupé, aucun des deux n'a la majorité. Un troisième nœud, ou l'arbitre Galera
garbd, est recommandé. - Le paramètre
HANodeNameactive aussi le mode HA natif de Zabbix (un nœud actif, les autres en attente, coordonnés par la base) ; ici, Pacemaker ne démarre de toute façon le service que sur un seul nœud.
¶ Références
- Documentation Zabbix 7.0 : haute disponibilité
- Documentation de Pacemaker (ClusterLabs)
- Documentation MariaDB : configurer MariaDB Galera Cluster
- Étapes précédentes : Installer un serveur Zabbix 7 sur Debian 12 et Créer une VM jumelle Zabbix
- Contexte du projet : Projet annuel 2025 : supervision Zabbix HA